
Hotel Lobby AI 提示词:原版和 5 段现成提示词
网上大多数 Hotel Lobby AI 提示词都是靠猜的。这里的不是:它们就是我们的生成器做 Hotel Lobby 视频用的提示词。第一段用于默认模型 Wan 3.0,它会保留 Hotel Lobby 音轨;按照 Wan 文档的写法,提示词用图1、图2、视频1 和音频1 来指代各个附件。第二段是 Seedance 版,会现写一首原创说唱。你可以直接复制,改成适合自己工具的写法,或者干脆跳过,交给生成器来做。再往下还有五段提示词,给只能上传两张照片的工具用:情侣、好朋友、祖孙、插画角色和宠物。
更新于
HOTEL LOBBY AI 提示词
用提示词指导表演
- 人物
- 动作
- 声音
Hotel Lobby AI 提示词原文
下面是两张照片、横屏(16:9 或 4:3,默认)的版本:比例作为参数传给模型,不写在提示词里。竖屏和方形(9:16、3:4、1:1)用的是另一条竖版参考视频,所以第三段还是旧的写法:两个主体完全替换视频里的两个人,两人都不戴手套。生成前,每张照片会先用 GPT Image 2 重画成同一个人(或宠物)的全身影棚照,模型按这个顺序收到四个附件:图1 是左边的人像,图2 是右边的人像,视频1 是去掉声音的 Hotel Lobby 参考视频,音频1 是剪成同样长度的 Hotel Lobby 音轨。
全程参照视频1:照搬它的取景、节奏和每一个动作、手势、转头、表情和嘴型,以及纯橙色背景和两人之间从天花板垂下的那支银色麦克风。保持视频1的机位取景,不要推近、拉远或平移。不要加入视频1里没有的动作或场景元素。

全程使用音频1作为整条视频的背景音乐,原样保留:它就是视频的全部声音。不要新写歌词,不要重唱,不要加入其他音乐或人声。

左边的表演者是图1里的主体,右边的表演者是图2里的主体。他们完全替换视频1里的两个人:左边的主体站在视频1左边那个人的位置,右边的主体站在视频1右边那个人的位置,每一帧都离镜头和他一样近,在画面里和他一样大。脸、发型或毛发、身材和衣服都来自照片,从第一帧到最后一帧都不变。视频1里左边那个人的蓝红长袍、右边那个人的深色毛衣只是他们自己的衣服,只用来参照动作,不要画到主体身上。主体如果是动物,就像人一样用两条后腿直立站着,用前爪做手势;它和视频1里同一边那个人一样高,两只后脚一直稳稳踩在地上,腿和身体的比例自然,脚下不要悬空;从第一帧到最后一帧都是这只动物,保持本来的样子,不加衣服,那个人的身体和衣服都不要留在画面里。忽略照片的背景。

左边的表演者对着麦克风说唱音频1的人声,嘴型与音频1精确同步。右边的表演者照着视频1右边那个人的动作:跟着节拍做反应和手势,只做简短的附和口型。

橙色铺满整个画面,没有黑色或暗角。不要分屏,不要多余的人,画面上不要字幕或文字。人脸从头到尾保持一致。
AI 说唱版(Seedance)
在 Seedance 上,声音一律是 AI 说唱:歌由模型自己重新写。在 Hotel Lobby 录音棚里,它写歌时会听到 Hotel Lobby 的原曲:参考视频去掉声音上传,原曲单独作为参考音频1上传,提示词要求跟着它的节奏做一段新的伴奏、写新歌词,不用它的旋律和人声。附件用文字来指代(“参考图片1”)。下面这段用的是一个示例主题。提示词里写了“用这个主题的语言来唱”,所以主题写成中文,AI 就用中文唱。
全程参照参考视频1的表演:照搬它的取景、节奏和每一个动作、手势、转头、表情和嘴型,以及纯橙色背景和两人之间悬挂的那支银色麦克风。保持参考视频1的机位取景:不要推近,不要拉远,不要平移。不要加入参考视频1里没有的动作或场景元素。

左边的表演者:参考图片1里的人。右边的表演者:参考图片2里的人。他们完全替换参考视频1里的两个人:脸、发型、身材和衣服都来自照片,参考视频1里的人一样都不要。照片里完全看不到某个人的衣服时(只有脸、或者光着肩膀),给这个人穿适合他的普通便装,比如简单的 T 恤和牛仔裤;绝不要参考视频1里那两个人的戏服、披风、外套、皮带、手套和蒙眼布。动物保持原样,不加衣服。忽略照片的背景。

配乐:一首为这条视频原创的暗黑亚特兰大 trap 歌曲,节拍和节奏跟着参考音频1走:同样的速度、律动、鼓点和弹跳感,卡准参考视频1里的动作。按这个风格做一段新的伴奏、写新歌词;不要重复使用参考音频1的歌词、旋律和人声。精简但有力:砸地、粗砺、在音符之间滑动的 808,尖锐的军鼓加拍手配利落的踩镲,再加一条阴森、带东方色彩的旋律循环。情绪暗、有压迫感、自信。说唱是快速、有弹性的三连音 flow,跑在缓慢的节拍上面。混音:人声清楚地在最上面,伴奏紧跟其后、几乎一样响,有力、有冲击感,从不变小,两句之间也不断。左边的表演者对着悬挂的麦克风说唱一段原创、干净的歌词,主题是:“Maya 的 30 岁生日和她糟糕的侧方停车”。用这个主题的语言来唱。说唱人声清晰,嘴型与每个字同步,自然地点头,嘴部表情丰富。右边的表演者是助兴搭档:指着说唱的人,做反应、微笑,跟着节拍加简短的附和。不要使用任何现成的歌曲、现成的歌词或任何真实歌手的声音。

9:16。橙色从一边铺到另一边,填满整个画面,没有黑色或暗的区域。不要分屏,不要多余的人,画面上不要字幕或文字。人脸从头到尾保持一致。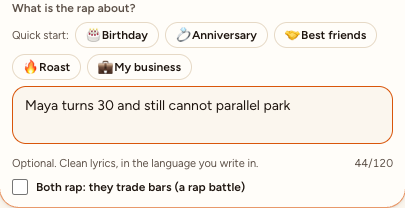
每一部分起什么作用
- 动作。第一段把一切都交给视频1:它的取景、节奏,每一个动作、手势、转头、表情和嘴型,纯橙色背景,以及两位表演者之间垂下的那一支银色麦克风。它让机位保持不动(不推近、不拉远、不平移),并排除视频1里没有的一切。
- 声音。音频1 就是整条视频的全部声音,原样保留:不写新歌词,不重唱,不加其他音乐或人声。
- 身份。每张图绑定一侧,每个主体站在视频里同一侧那个人的位置,离镜头一样近,在画面里一样大。脸、发型或毛发、身材和衣服都来自图片,从第一帧到最后一帧都不变,背景一律忽略。提示词写的是“图1里的主体”,不写男人或女人,人和宠物都适用,永远不会和照片打架。它写出参考视频里两个人穿的衣服(蓝红长袍、深色毛衣),只是为了不让模型把这些衣服画到你的主体身上。2026 年 10 月 17 日起,横屏参考视频里是两个穿普通衣服的人;之前那条视频里是两个奇幻替身,成片偶尔会留下他们的手套、蒙眼布,甚至整套戏服。2026 年 10 月 22 日起,最后一句还要求动物像人一样直立、和同一边那个人一样高、到最后一帧都还是这只动物:用这条参考视频测试时,原来较短的写法会让视频里的人顶替掉狗。前爪仍常被画成手。
- 分工。左边的表演者唱音频1 里的人声,嘴型同步;右边的人照着视频里的助兴搭档,跟着节拍做反应和手势,只做简短的 ad-lib。
- 护栏。橙色铺满整个画面、没有黑边或暗角,不分屏、不多加人、不加字幕,脸从头到尾保持一致。这几条能挡住最常见的翻车。
怎么用到其他 AI 视频工具里
- 模型得能接收参考图、参考视频和参考音轨,并且保留音轨。Wan 3.0 可以;字节跳动的 Seedance 2.x 三样都能接收,但在我们的测试里写出了新的音乐。
- 把引用写法换成你所用工具的语法。Wan 写的是图1、视频1 和音频1;其他工具要写成 “Image 1” 和 “Video 1”,或者有自己的标签。顺序别变:先左边照片,再右边照片。
- 表演者的称呼保持中性。“图1里的主体”适合图里的任何人或宠物;我们的生成器只改照片布局(两张照片或一张合照),以及用你自己的片段时的动作。
- 画面比例不写在提示词里:在工具的设置里选 9:16、16:9 或 1:1。
- 没有参考视频的话,就别指向视频1,改用文字描述录音棚和动作。Dreamina 等工具为此公开了自己的纯文字提示词。我们只测试过上面这两个版本。
只用两张照片、不带参考视频的 Hotel Lobby AI 提示词
很多 AI 视频工具能接收参考照片,却不能接收参考视频。这五段提示词改用文字来描述录音棚和动作,可以直接粘贴到能上传两张照片的图生视频工具里。它们保留了这个玩法成立的几条规则:一侧一张照片,只有一支吊麦,一个人主唱、另一个人做反应,机位始终不动。这些提示词是我们为这篇指南写的,没有测试过;每个工具理解提示词的方式都略有不同,可能要多试一两次。
情侣版 Hotel Lobby AI 提示词
用两张参考照片生成一条 12 秒的 9:16 竖屏视频。图1里的人站在左边,图2里的人站在右边,两人都是全身入镜,各自保留自己的脸、发型、衣服和身高。他们是一对情侣,在一间简洁、光线均匀的橙色录音棚里合唱一段说唱:橙色的墙和地面,房间里没有别的东西。一支银色电容麦克风用细线从天花板垂下,挂在两人正中间。左边的表演者对着麦克风说唱,手势自信;右边的表演者笑着指向对方,跟着节拍跳舞,最后一句时凑到麦克风前。固定机位,镜头在胸口高度,一镜到底:不切镜头,不推拉,不平移。不要其他人,不要字幕,不要标志。好朋友版
用两张参考照片生成一条 12 秒的 9:16 竖屏视频,照片里是两个成年的好朋友。图1里的人在左边,图2里的人在右边,两人都是全身入镜,脸、发型、穿着和体型都与照片完全一致。场景:一间简洁的橙色录音棚,橙色的墙和地面无缝连成一片,一支银色麦克风从天花板垂下,挂在两人之间。前半段,左边的朋友对着麦克风说唱,右边的朋友点头、咧嘴笑,用夸张的手势助兴;后半段两人互换,右边的朋友说唱,左边的朋友做反应。两人的动作各做各的,绝不镜像。固定机位,一镜到底,光线柔和均匀,两人的身体和脚都在画面里。不要多余的人、道具、文字或标志。祖孙版
用两张参考照片生成一条 12 秒的 9:16 竖屏视频。图1是一位老人,站在左边;图2是这位老人已成年的孙辈,站在右边。两人都是全身入镜,各自保留自己的脸、发型、衣服和身高。他们在一间简洁的橙色录音棚里合唱一段说唱,一支银色麦克风从天花板垂下,挂在两人之间。老人对着麦克风说唱,手势缓慢、从容、自信;孙辈一脸惊讶,笑着跟着节拍跳舞,最后一句时加入一起唱。两人的动作都自然、舒适。固定机位,一镜到底,录音棚光线均匀:不切镜头,不推拉,不平移,不要其他人,不要字幕。动漫或卡通角色版
请用你自己画的角色,或者你有权使用的角色;知名角色的版权属于别人。
用两张参考图生成一条 12 秒的 9:16 竖屏视频,图里是两个原创插画角色。图1里的角色站在左边,图2里的角色站在右边,都是全身入镜,各自的画风、配色、比例和服装都与原图完全一致,并用这种画风来呈现两个角色。他们在一间简洁的橙色录音棚里合唱一段说唱,一支银色麦克风从天花板垂下,挂在两个角色之间。左边的角色对着麦克风说唱,手势丰富、有表现力;右边的角色做反应,指向对方,跟着节拍跳舞。固定机位,一镜到底,不切镜头,不推拉,不平移。不要多余的角色,不要文字,不要标志。宠物版 Hotel Lobby AI 提示词
最早爆火的一批 Hotel Lobby 视频里就有猫和狗,是用其他工具做的(在这里看)。每只动物用一张清晰的照片,全身都要拍进去。
用两张宠物参考照片生成一条 12 秒的 9:16 竖屏视频。图1里的动物用后腿直立,站在左边;图2里的动物站在右边。两只动物各自保留自己的品种、脸、眼睛颜色、毛色花纹、体型和项圈。它们在一间简洁的橙色录音棚里,一支银色麦克风从天花板垂下,挂在它们之间。左边的动物跟着节拍动嘴,用前爪比划,就像在对着麦克风说唱;右边的动物跟着节拍点头,看向镜头,随着节拍舞动。身体结构自然:每只都是四条腿、一条尾巴,从耳朵到爪子都完整地出现在画面里。固定机位,一镜到底。不要人,不要多余的动物,不要文字。在我们的生成器上,不管是人还是宠物,这些提示词都用不着:提示词已经内置,宠物说唱视频页会把生成器设好,放你的宠物和它的搭档。我们测试过人和狗同台;猫、两只宠物同框还没有测试。
常见翻车和解决办法
| 问题 | 可能的原因 | 解决办法 |
|---|---|---|
| 脸走样,或者看起来像另一个人 | 照片是侧脸、戴了墨镜,或者脸太小 | 用正脸、光线好的半身照 |
| 两个人站反了 | 提示词没有把每张照片绑定到一侧 | 写明左边和右边的表演者各对应哪张图 |
| 多出第三个人 | 模型从参考视频或照片背景里复制了人 | 保留“不要多余的人”和“忽略照片的背景” |
| 画面上冒出文字 | 模型自己加了字幕 | 保留“画面上不要字幕或文字” |
| 口型对不上音频 | 没附音频,或者音频开头是空白 | 附上音轨,并从有歌词的地方开始 |
| 橙色四周出现黑边 | 提示词要了参考视频里没有的运镜 | 保持参考视频的取景,并要求橙色铺满整个画面 |
| 出来的是新音乐,不是原音轨 | 模型自己写了配乐(我们测试时 Seedance 2.x 就是这样) | 换用能保留参考音轨的模型,比如 Wan 3.0 |
或者干脆跳过提示词
在 Hotel Lobby Video 上,这段提示词、参考视频和参考音轨都已经内置。你只要放两张照片,然后点生成。Wan 3.0 上 12 秒、480p 的视频 6 积分。
常见问题
Hotel Lobby AI 潮流用什么提示词最好?
能把这几件事写死的提示词:录音棚、唯一一支吊麦、哪张照片站哪一边、每个人做什么。上面这段就是我们的生成器给每个视频用的提示词。
这段提示词适用于哪些 AI 模型?
第一段我们用在 Wan 3.0 上,它会保留参考音轨;AI 说唱版用在 Seedance 2.x 上,它会自己写音乐。两者都能接收参考图、参考视频和参考音轨。其他模型需要换成它们自己的引用语法,而且不一定三样都支持。
有给宠物用的 Hotel Lobby AI 提示词吗?
有,就是上面的宠物版,适用于能上传两张照片的工具:每只动物一张照片,各自对应一侧,用后腿直立,身体结构保持自然。在 Hotel Lobby Video 上不用写提示词:宠物说唱视频页已经为宠物和它的搭档设好。我们测试过人和狗同台;猫、两只宠物同框还没有测试。
这些提示词能粘贴到 Dreamina、可灵(Kling)或其他工具里吗?
这五段只用照片的提示词,是为能上传两张参考照片的图生视频工具写的。把图1、图2 换成你所用工具对照片的叫法,左右位置保持不变。我们没有在其他工具里测试过它们。
做 Hotel Lobby AI 视频一定要写提示词吗?
用两张照片的生成器就不用。在 Hotel Lobby Video 上提示词是内置的,你只需要添加照片。
资料来源
接着看
Hotel Lobby 潮流怎么做?3 种方法详解(2026)
做 Hotel Lobby AI 爆款视频的 3 种方法(两张照片生成器、AI 视频提示词、剪辑模板),附步骤、费用、免费选项和小技巧
Hotel Lobby AI 视频生成器哪个好?16 款对比
各家 Hotel Lobby 视频工具对比(Hotel Lobby Video、Make Hotel Lobby、HotelLobby.me、Remake Your Meme、Rap Duo AI、LightX、Dreamina、Fuzana 等),信息来自各家自己的页面,注明核对日期
Hotel Lobby AI 照片怎么选:哪些照片效果最好
Hotel Lobby AI 照片清单:该选什么,重画会对照片做什么,两张照片还是一张合照,以及换好照片也解决不了的问题
Hotel Lobby Video 是独立工具,与 Quavo、Takeoff、Migos、Quality Control Music、Motown 和 COLORS 均无关联。